VS Code+Codexで株式情報取得WEBシステムを構築してみた ― 要件定義からFastAPI/MySQL/Nginx実装・テストまで
※本記事は、VS Code上でCodexを利用して開発した「KABUINFO_GET」のソース一式をもとに、構築の流れを整理したものです。株式売買を推奨する記事ではありません。実注文を伴う機能は、証券会社(三菱UFJ Eスマート証券)のAPI仕様・利用規約・利用者自身の確認を前提にしてください。
はじめに
今回、VS CodeとCodexを使い、東証株式の情報取得・表示・分析・注文管理を想定したWEBシステムを構築しました。私自身は、SE(システムエンジニア)ですが、今回は、プログラムは一切書いていません。すべてChatGPTのCodexに任せています。
※開発期間は、基本機能は搭載して、残機能がありますが、ChatGPT6.1 Solを利用して、2日間半(2h+8h+4h=14h)です。(ChatGPT PlusでCodexを利用して、できるだけ追加費用はかけない様にしています)システム会社に任せると、この規模感のこの完成度であれば、開発期間に3か月ぐらいかかるかとは思います。
システム名は KABUINFO_GET です。
開発で重視したのは、単に「AIにコードを書かせる」ことではありません。最初にユーザー要望を文書化し、確認事項を整理し、要件定義、基本設計、詳細設計、タスク分割、実装、テスト、構築手順まで段階的に作成しました。
Codexには、いきなり全機能のコード生成を依頼するのではなく、要件を文書化してから、設計と実装を小さなタスクへ分解して進める方法を採用しています。
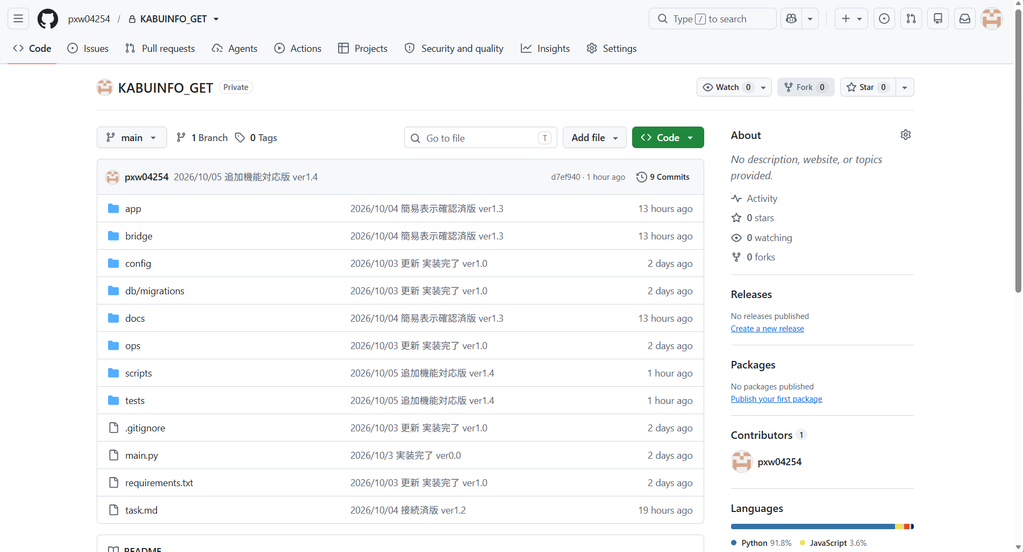
【画像1 :GitHubのRepositories一覧】
キャプション例:GitHubに作成した KABUINFO_GET リポジトリ。開発途中のソースをGitで管理した。
目次
- 今回作成したシステム
- 技術スタック
- システム構成
- いきなり実装せず、最初に要件を文書化した
- Codexに与える指示を「工程単位」にした
- 66個のタスクへ分解した
- プロジェクト構成
- Python仮想環境と依存パッケージ
- 設定ファイルはソースと秘密情報を分離する
- FastAPIの起動部分
- APIと画面を分離する
- 初回版を「表示専用」に固定した
- 認証・セキュリティ
- MySQLはマイグレーションで管理する
- テストもCodexに作らせる
- Windowsへのローカル構築
- Git/GitHubで管理する
- Codexを使って感じたこと
- 今回の開発で特に良かった点
- 今後の作業
- まとめ
1. 今回作成したシステム
KABUINFO_GETは、Windows PC上で動作するWEBシステムです。kabuステーションAPIとの連携を前提に、株式情報を取得してブラウザーから確認できる構成にしています。
主な対象機能は次のとおりです。
- 銘柄検索
- 株価・板情報の表示
- 注目銘柄管理
- 保有株・取引余力の表示
- 注文・成立状況の表示
- 現物・信用注文および取消を想定した処理
- 上昇傾向、値下がり後の回復、出来高急増の分析
- ダッシュボード
- ユーザー認証、TOTPによる多要素認証
- 一般ユーザー/運用管理者の権限制御
- 操作ログ
- CSV出力
- 通知
- バックアップ・復元
- Windows上での起動・停止補助
ただし、現在の初回リリース方針は安全性を優先し、本人1名向けの表示専用版です。株価・板・保有・余力・注文一覧などの読取を初回対象とし、注文・取消・分析などは後続リリースに分離しています。
これは「画面上の注文ボタンを隠す」だけではなく、アプリケーション側でも後続機能のAPIを拒否する設計にしています。
2. 技術スタック
今回の正式構成はWindowsを前提に、次の技術を採用しました。
| 分類 | 採用技術 |
|---|---|
| OS | Windows 11以上 |
| 言語 | Python 3.13系 |
| WEBフレームワーク | FastAPI |
| ASGIサーバー | Uvicorn |
| リバースプロキシ | Nginx for Windows |
| DB | MySQL 8.4系 |
| DB接続 | PyMySQL |
| テンプレート | Jinja2 |
| フロント | HTML / JavaScript / Bootstrap 5 |
| パスワード保護 | Argon2id |
| 暗号化 | AES-GCM(cryptography) |
| TOTP | pyotp |
| HTTPクライアント | httpx |
| テスト | pytest |
| ソース管理 | Git / GitHub |
| 開発環境 | Visual Studio Code + Codex |
当初はGunicornも候補に入れていましたが、Windows中心の構成であるため、最終的には Gunicornを使用せず、Uvicornを直接利用する構成としました。
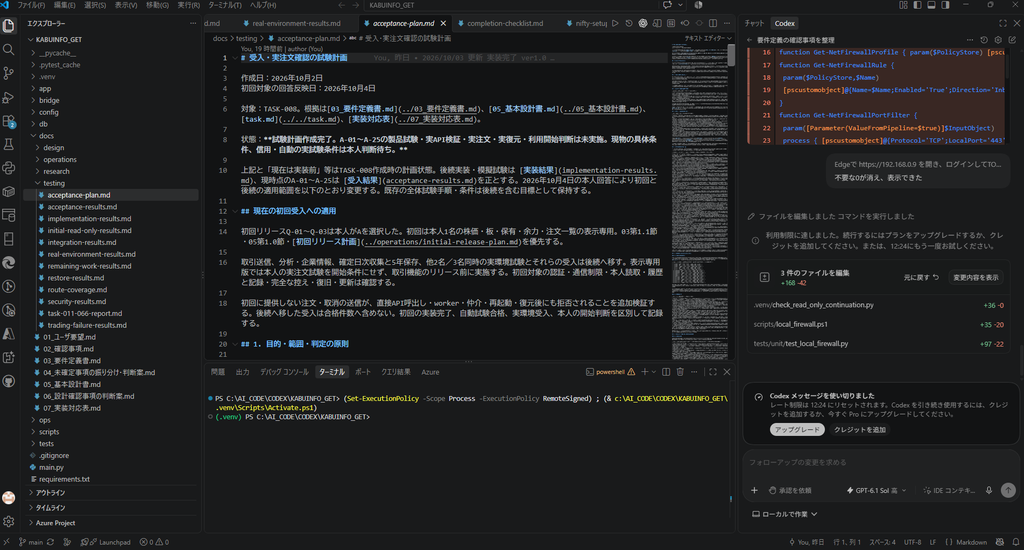
【画像2 :VS CodeでKABUINFO_GETを開いた画面】
キャプション例:VS Codeでプロジェクト全体を開いた状態。左側のExplorerにapp、bridge、docs、testsなどが並ぶ。
3. システム構成
全体構成は、ブラウザーからNginxを経由してFastAPIへアクセスし、業務データをMySQLに保存する構成です。
Edge / Chrome
      |
    HTTPS
      |
    Nginx
      |
  127.0.0.1
      |
FastAPI / Uvicorn
   |          |
 MySQL      Worker
              |
        定期処理・通知

利用者PC側
  bridgeプロセス
      |
 localhost
      |
kabuステーションAPI
ポイントは、証券APIを共有PCから直接LAN公開しないことです。各利用者のPC上で動作する bridge が、そのPCのlocalhostにあるkabuステーションAPIへ接続します。
本番用APIは localhost:18080、検証用APIは localhost:18081 を前提としています。
共有WEBと証券APIの秘密情報を分離することで、ブラウザーや共有DBに証券APIの秘密をそのまま置かない構成にしました。
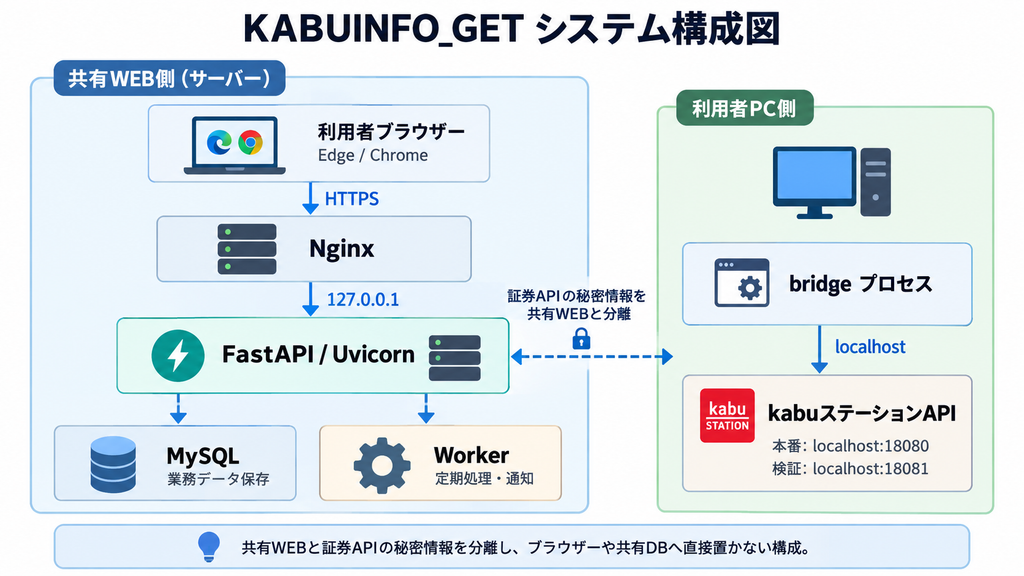
【画像3 :KABUINFO_GET システム構成図】
4. いきなり実装せず、最初に要件を文書化した
この開発で特に効果があったのは、Codexへ最初から「全部作って」と依頼しなかったことです。
リポジトリの docs フォルダーには、開発の根拠となる資料を段階的に残しています。
docs/
  01_ユーザ要望.md
  02_確認事項.md
  03_要件定義書.md
  04_未確定事項の振り分け・判断案.md
  05_基本設計書.md
  06_設計確認事項の判断案.md
  07_実装対応表.md
最初の01_ユーザー要望.mdには、たとえば次の内容を記載しました。
・東京証券取引所の株情報を取得する
・PythonでWEBシステムを作成する
・FastAPI / MySQL / Nginx / Uvicorn / Jinja2 / Bootstrapを利用する
・株価、板、銘柄情報を取得する
・現物、信用注文、取消、余力確認を想定する
・収集情報から購入候補を分析できるようにする
・ID、パスワード、外部認証コードでログインする
・一般ユーザーと運用管理者を分ける
・TOP画面をダッシュボード形式にする
この要望からCodexに確認事項を抽出させ、決めきれないものは勝手に実装させず、「確認待ち」「技術調査」「設計で補完」に分類しました。
AI駆動開発では、この工程を省略するとAIが不足情報を推測して仕様を作り込んでしまうことがあります。そこで、確定事項と未確定事項を明示的に分けることを重視しました。
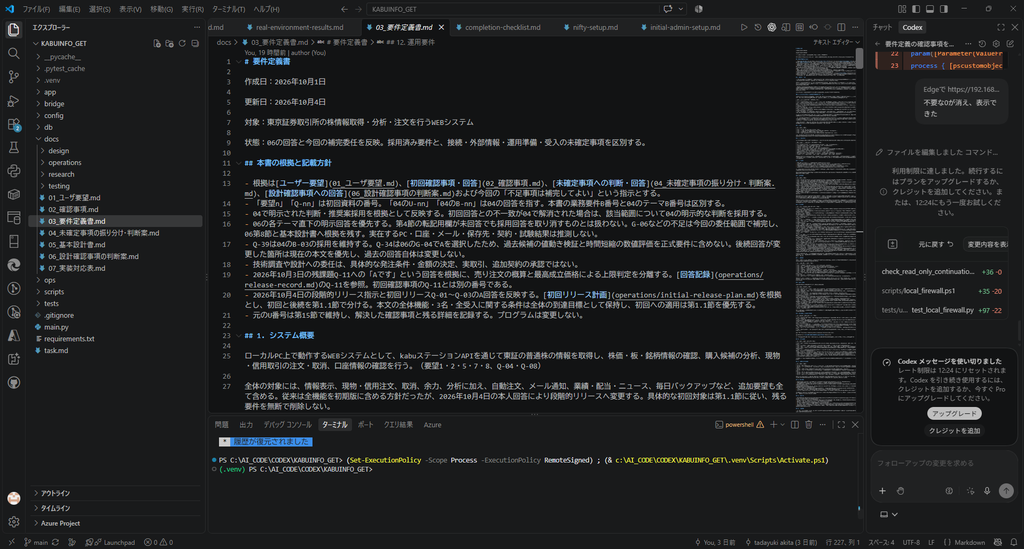
【画像4 :VS Codeで docs/03_要件定義書.md を開いた画面】
キャプション例:Codexと整理した要件定義書。機能要件だけでなく、セキュリティ・運用・未確定事項も管理しています。
5. Codexに与える指示を「工程単位」にした
実際の会話ログそのものではありませんが、今回の進め方を再現するなら、以下に記載の①~⑥の順序にて依頼しています。
①まずプログラム開始時の前提指示として、次のような指示が有効です。
このプロジェクトでは、いきなり実装を開始しないでください。

1. 01_ユーザ要望.mdを確認する
2. 不足している確認事項を整理する
3. 確定事項と未確定事項を分離する
4. 要件定義書を作成する
5. 基本設計書を作成する
6. 実装タスクを依存関係順に分割する
7. 実装前にテスト条件を定義する

不明な外部API仕様を推測で確定しないでください。
実注文は行わず、まず模擬環境で検証してください。
【システム構築の前提指示文】
②次にシステム要件定義前に、事前分類作業を依頼します。
docs/01_ユーザ要望.mdを確認してください。
これからこのシステムの要件定義を行います。
現時点ではプログラムを作成・変更しないでください。
ユーザ要望を分析して、以下に分類してください。
1. 業務要件
2. 機能要件
3. 非機能要件
4. 画面要件
5. データ要件
6. 外部インターフェース要件
7. 運用要件
8. セキュリティ要件
また、要件定義を行うために情報が不足している項目を
「確認事項」として一覧化してください。
推測で仕様を決定しないでください。
【システム要件資料、確認事項作成の指示文】
③要件定義書を作成します。以下の様な指示文でお願いしています。
docsフォルダに作成した要件資料と確認事項への回答をもとに、
正式な要件定義書を作成してください。
【入力資料】
docs配下の以下のファイルをすべて確認してください。
・01_ユーザ要望.md
・02_業務要件.md
・02_機能要件.md
・03_非機能要件.md
・04_画面要件.md
・05_データ要件.md
・06_外部インターフェース要件.md
・07_運用要件.md
・08_セキュリティ要件.md
・09_確認事項.md
【重要】
09_確認事項.mdには、要件確認に対する回答・決定事項が記録されています。
確認事項で確定した内容については、その回答を優先して各要件へ反映してください。
ユーザ要望と確認事項を最上位の根拠とし、
Codex自身の推測で要件を追加・確定しないでください。
資料間に矛盾がある場合は、勝手にどちらかを採用せず、
「要確認事項」として明示してください。
【作成する成果物】
docs/10_要件定義書.md
として新規作成してください。
要件定義書は以下の構成としてください。
1. 文書概要
   ・目的
   ・対象システム
   ・対象範囲
   ・前提条件
2. システム概要
   ・システム化の背景
   ・目的
   ・想定利用者
   ・システム全体像
3. 業務要件
   ・対象業務
   ・業務概要
   ・業務フロー
   ・業務ルール
4. 機能要件
   各機能に一意の要件IDを付与してください。
   例:FR-001、FR-002
   各機能について、
   ・要件ID
   ・機能名
   ・目的
   ・利用者
   ・入力
   ・処理
   ・出力
   ・関連業務
   ・関連画面
   ・備考
   を整理してください。
5. 画面要件
   各画面に画面IDを付与してください。
   例:SCR-001
6. データ要件
   ・主要エンティティ
   ・保持する情報
   ・データ間の関係
   ・保存期間等
7. 外部インターフェース要件
   ・連携先
   ・連携方式
   ・送受信データ
   ・タイミング
8. 非機能要件
   ・性能
   ・可用性
   ・拡張性
   ・バックアップ
   ・ログ
   ・監視
9. セキュリティ要件
   ・認証
   ・認可
   ・アクセス制御
   ・データ保護
   ・監査ログ
10. 運用・保守要件
    ・運用方法
    ・障害対応
    ・バックアップ
    ・保守方法
11. 制約事項・前提条件
12. 未確定事項
    現時点で決定できないものだけを記載してください。
13. 要件トレーサビリティ
    「ユーザ要望 → 業務要件 → 機能要件 → 画面」
    の対応関係を可能な範囲で整理してください。
【作成ルール】
・既存の01~09のファイルは変更しないでください。
・プログラムソースは変更しないでください。
・今回は10_要件定義書.mdのみ新規作成してください。
・確定事項と未確定事項を明確に区別してください。
・同一内容の重複記載は統合してください。
・要件の抜け漏れがないか01~09を横断して確認してください。
・要件の根拠が分かるようにしてください。
・推測で仕様を追加しないでください。
・実装方法ではなく「システムとして何を満たす必要があるか」を中心に記載してください。
作成後、ファイルを変更せずに、
以下をチャットに報告してください。
1. 作成した要件数
2. 機能要件数
3. 画面数
4. 未確定事項数
5. 資料間で発見した矛盾
6. 要件として不足している可能性がある事項
【要件定義書作成の指示文】
④次に基本設計を実施します。以下の様な指示文です。
docs/03_要件定義書.md
docs/02_確認事項.md
docs/04_未確定事項の振り分け・判断案.md
を正式な要件として基本設計を作成してください。
以下を作成してください。
・システム構成
・画面一覧
・画面遷移
・画面項目
・機能一覧
・機能仕様
・DB設計
・テーブル一覧
・テーブル定義
・ER構成
・API一覧
・認証・認可方式
・エラー処理
・ログ設計
・セキュリティ設計
docs/04_基本設計書.md
として作成してください。
この段階ではプログラムを変更しないでください。
要件定義書に記載されていない仕様を独自判断で確定しないでください。
不明点は「設計確認事項」としてください。
【基本設計の指示文】
⑤次にタスク分割します。以下の様な指示文です。
docs/03_要件定義書.md
docs/05_基本設計書.md
を確認してください。
実装作業を開始する前に、
システム構築に必要な作業を実装可能な単位へ分割してください。
依存関係を考慮して実装順に並べ、
task.md
を作成してください。
各タスクには以下を記載してください。
・Task ID
・作業内容
・対象ファイル
・参照する要件
・実装内容
・完了条件
・テスト内容
まだプログラムは変更しないでください。
【タスク定義作成の指示文】
⑥実装段階では、さらにタスク単位(Task-01~Task-66)単位に指示します。この方法にすると、Codexが大きな変更を一度に行うリスクを下げられます。
task.md の Task-01を実装してください。
docs/03_要件定義書.md
docs/05_基本設計書.md
を必ず遵守してください。
今回変更するファイルを最小限にしてください。
関係のないファイルは変更しないでください。
実装後にテストを実行してください。
最後に、
・変更したファイル
・実装内容
・テスト内容
・テスト結果
・残課題
を報告してください。
【task.md内の66タスクから実装する為の指示文】
6. 66個のタスクへ分解した
task.md では、システム全体を66個のタスクに分割しています。
大きく分けると次の8工程です。
| 工程 | 内容 |
|---|---|
| 1 | 調査・確認 |
| 2 | 詳細設計 |
| 3 | 共通基盤・認証・仲介 |
| 4 | 情報取得・手動注文 |
| 5 | 分析・自動注文・通知・CSV |
| 6 | 画面 |
| 7 | 保守・保存・構築手順 |
| 8 | 結合・実機・受入 |
たとえば共通基盤では、設定、DB移行、暗号化、認可、TOTP、メール、セッション、定期処理などを先に作り、その後に株価取得や注文処理を実装しています。
この順番にしたことで、「画面はできたが認証基盤がない」「注文機能を作ったがDB状態管理がない」という状態を避けやすくなりました。
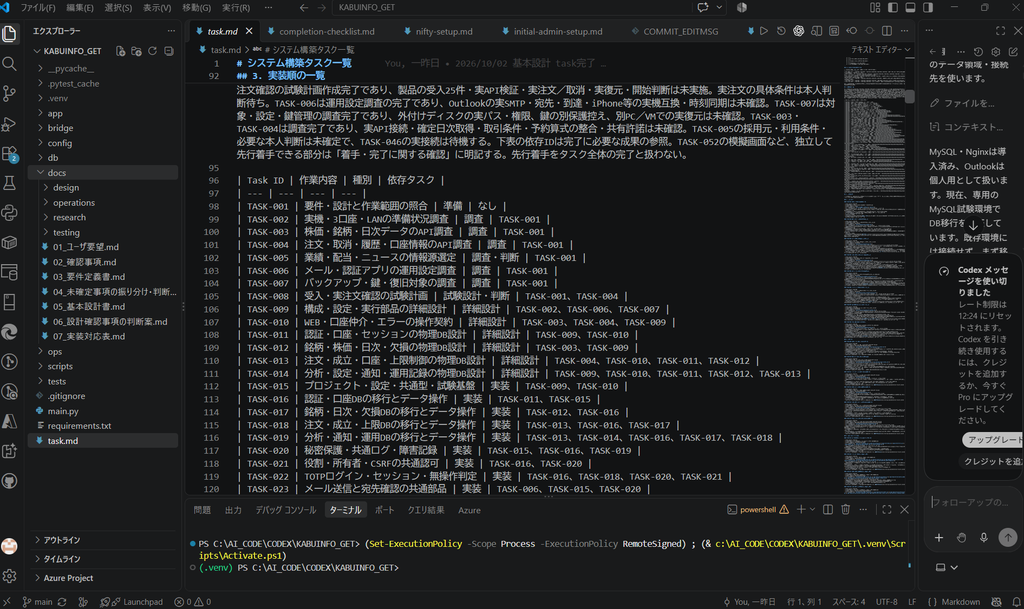
【画像5 :task.md の工程とTASK-001〜066画面】
キャプション例:要件を66タスクに分解し、依存関係順でCodexに実装させた。
7. プロジェクト構成
現在のリポジトリは、おおむね次の構成になっています。
KABUINFO_GET/
├─ app/
│  ├─ api/             # FastAPI API
│  ├─ core/            # 設定、認可、暗号、CSRF、共通処理
│  ├─ db/              # DB接続
│  ├─ integrations/    # メール・外部情報連携
│  ├─ jobs/            # 定期処理
│  ├─ repositories/    # DBアクセス
│  ├─ services/        # 業務ロジック
│  ├─ static/          # CSS / JavaScript / Bootstrap
│  ├─ templates/       # Jinja2 HTML
│  ├─ web/             # 画面ルーティング
│  ├─ main.py
│  └─ worker.py
├─ bridge/              # 利用者PCとkabuステーションAPIの仲介
├─ config/              # 設定例
├─ db/migrations/       # MySQLマイグレーション
├─ docs/                # 要件・設計・試験・運用資料
├─ ops/                 # MySQL / Nginx設定例
├─ scripts/             # PowerShell運用補助
├─ tests/               # unit / integration / security / UI等
├─ main.py
├─ requirements.txt
└─ task.md
【プロジェクト構成】
添付ソースを確認すると、Pythonファイルは200本以上、テストファイルも多数あり、単一ファイルに処理を詰め込まず責務ごとに分離されています。
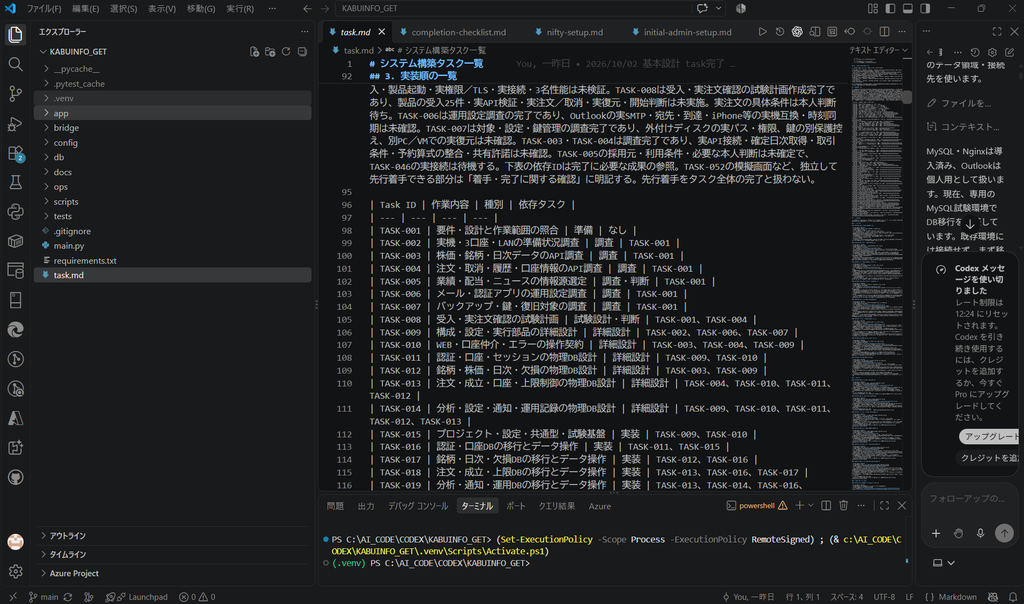
【画像6 :VS Code Explorerでフォルダー全体を展開した画面】
8. Python仮想環境と依存パッケージ
環境構築ではPythonの仮想環境を作成し、requirements.txt から依存関係のソフトを導入します。
PowerShellの例です。
python -m venv .venv
.\.venv\Scripts\Activate.ps1
python -m pip install --require-hashes -r requirements.txt
python -m pip check【requirements.txt から依存関係のソフトを導入するshell】
このプロジェクトの requirements.txt は、単にバージョンを固定するだけでなく、パッケージのSHA-256も指定しています。
たとえばFastAPI、Uvicorn、Jinja2、PyMySQL、cryptography、argon2-cffi、pyotp、httpx、pytestなどを固定しています。
依存関係を固定しておくことで、別PCへ配置した際に「最新版へ変わったため動かなくなった」という問題を減らせます。
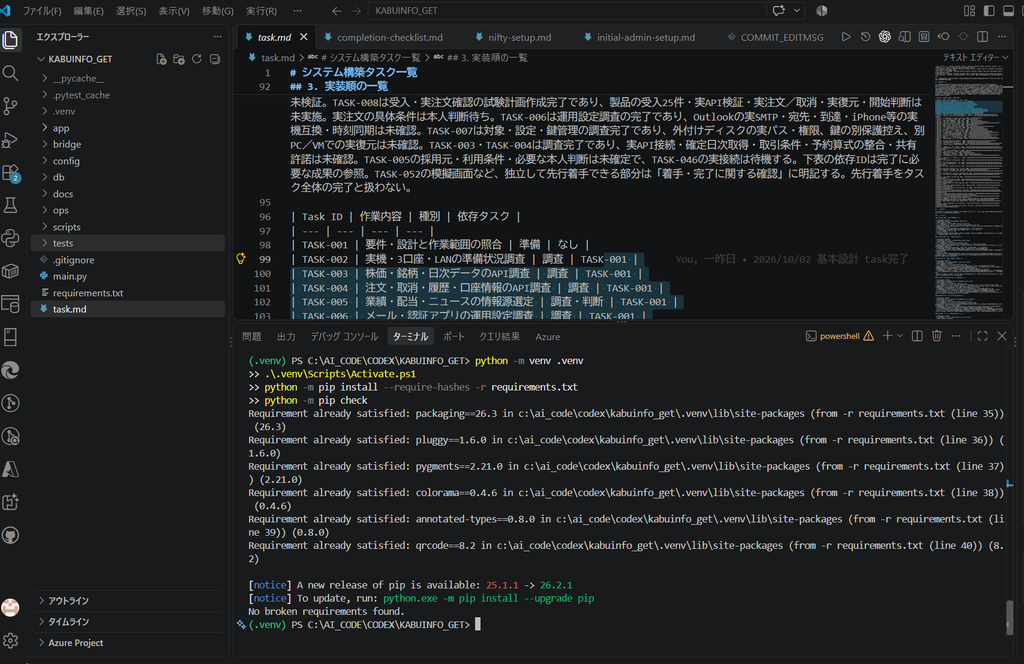
【画像7 :VS Codeターミナルでpip install / pip checkが成功した画面】
9. 設定ファイルはソースと秘密情報を分離する
設定例は config/settings.example.toml に置いています。
一部を簡略化すると次のような構造です。
[application]
schema_version = 1
environment = "unset"
[web]
host = “127.0.0.1” port = 8000 workers = 1 public_url = “” https_port = 443
[database]
host = “127.0.0.1” port = 3306 name = “” charset = “utf8mb4”
[bridge]
enabled = false production_local_url = “http://localhost:18080/kabusapi” test_local_url = “http://localhost:18081/kabusapi”
実際のパスワード、API秘密、暗号鍵は、このTOMLへ直接記載しない設計です。
Gitの .gitignore でも .env、.venv、Pythonキャッシュなどを除外しています。
.env
.venv/
__pycache__/
*.pyc
.pytest_cache/【.gitignore の設定例】
GitHubへ公開・保存する際は、設定ファイルそのものよりも、秘密情報が履歴へ入らない運用が重要です。
10. FastAPIの起動部分
ルートの main.py は、設定ファイルを引数で受け取り、設定を読み込んでUvicornを起動する構成です。
考え方を抜粋すると次のようになります。
settings = load_settings(args.config, "web")

server = uvicorn.Server(
    uvicorn.Config(
        create_app(settings, Services(settings)),
        host=settings.web.host,
        port=settings.web.port,
        workers=1,
        proxy_headers=True,
        forwarded_allow_ips="127.0.0.1",
        access_log=False,
    )
)

server.run()【main.pyのFastAPI箇所設定例】
FastAPIを直接LANへ公開するのではなく、通常は 127.0.0.1:8000 で待ち受け、外部からはNginxのHTTPS経由でアクセスさせます。
11. APIと画面を分離する
FastAPIでは、画面表示とJSON APIを分けています。
画面側には、たとえば次のURLがあります。
/login
/top
/symbols
/symbols/{id}
/orders
/positions
/analysis
/settings
/logs
/notifications
/backups
一方、業務処理は /api/... に分けています。
GET  /api/symbols
POST /api/market/refresh
GET  /api/positions
GET  /api/orders
POST /api/orders/preview
POST /api/orders
POST /api/orders/cancellations
POST /api/analysis/run
GET  /api/operation-logs
この分離により、Jinja2で画面を表示しながら、必要な部分だけJavaScriptからAPIで更新できます。デザインは、おしゃれなものに変更予定です。APIから簡単に、株情報を取得ができる様になっていました。
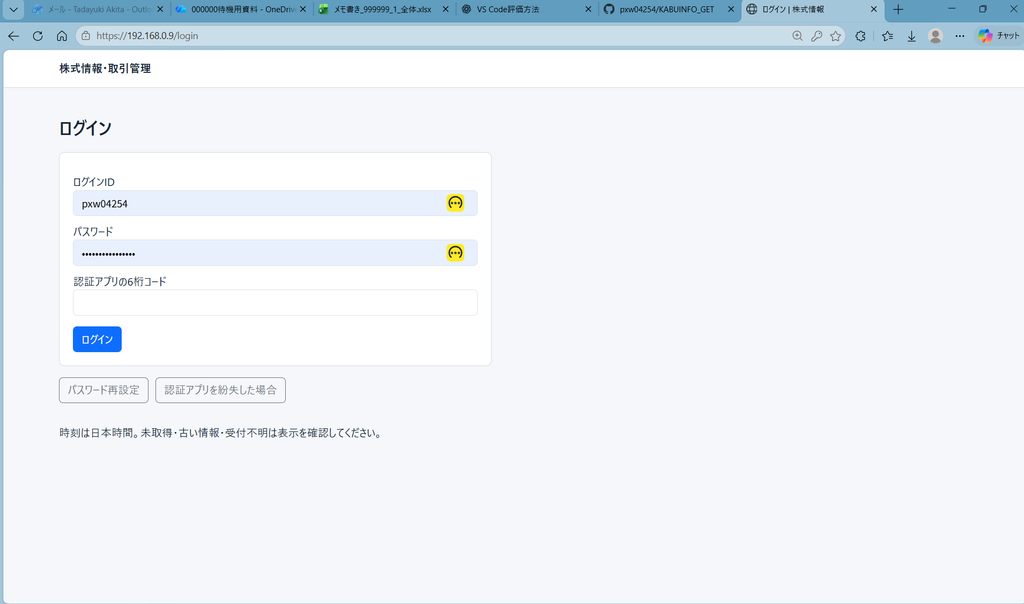
【画像8 :ログイン画面】
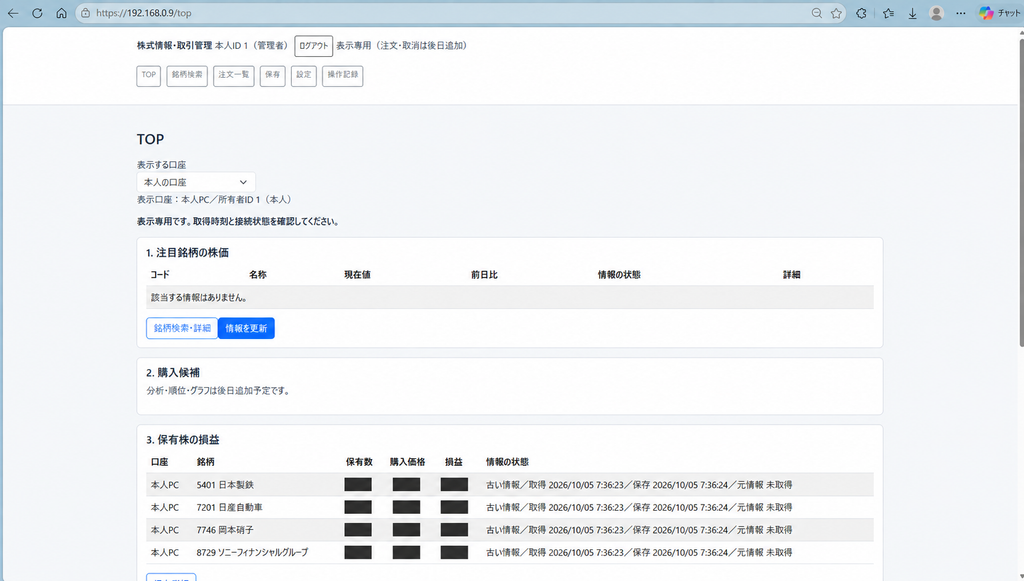
【画像9 :TOPダッシュボード】
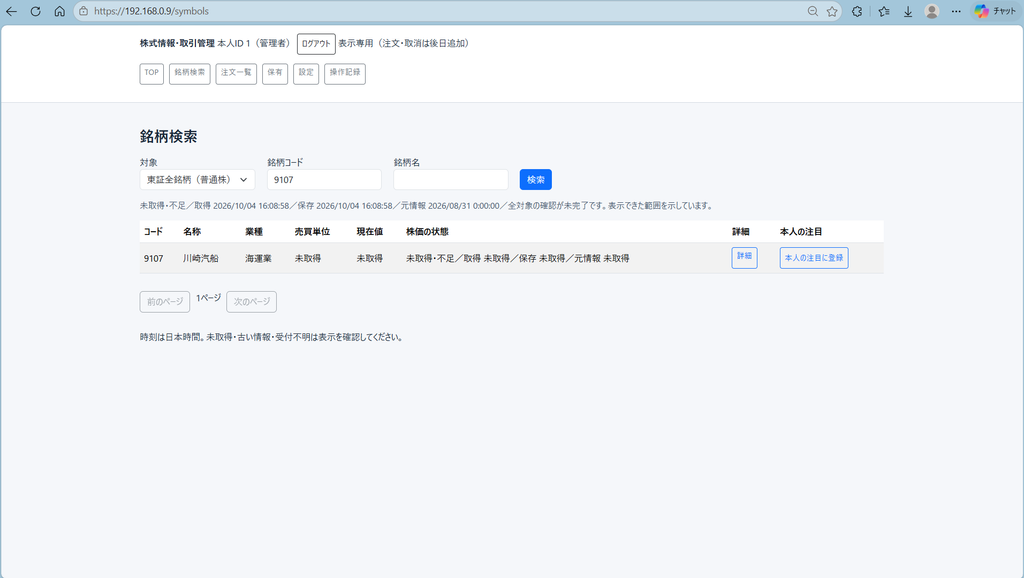
【画像10 挿入位置:銘柄検索画面】
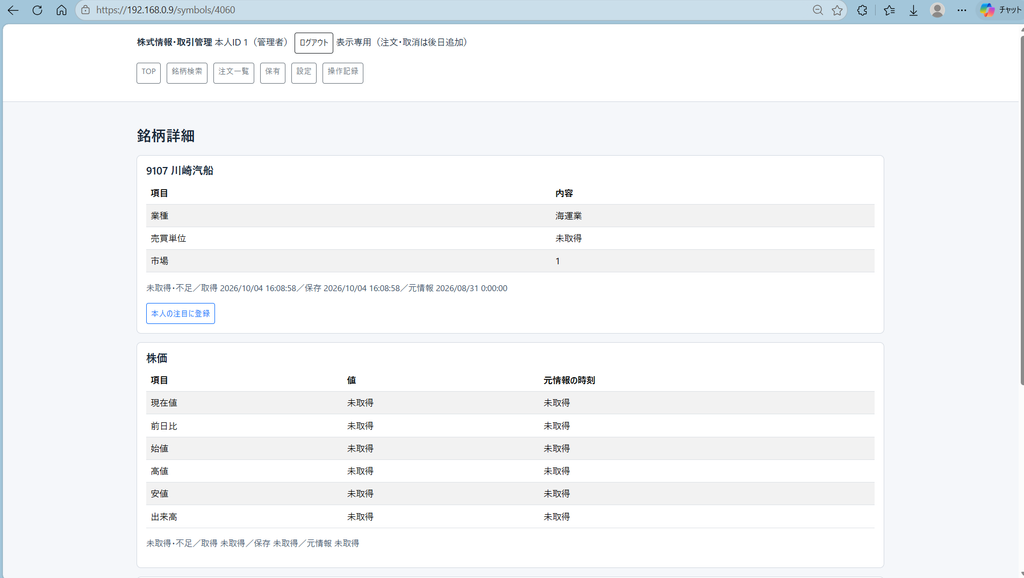
【画像11 挿入位置:銘柄詳細・板画面】
12. 初回版を「表示専用」に固定した
今回、安全面で特に重要だったのが初回リリース制御です。
app/core/release_scope.py では、初回版が表示専用であることをコード側で固定しています。
def initial_read_only():
    return True


def require_full_release():
    if initial_read_only():
        raise AppError("FEATURE_DEFERRED")
さらに、注文、取消、分析、自動注文などの対象ルートを初回版では拒否します。
つまり、設定ファイルを書き換えるだけで注文機能をONにする方式にはしていません。
後続版で注文機能を提供する場合は、プログラムのリリースそのものを変更し、改めて受入試験を行う考え方です。
これは、金融系のシステムでAI生成コードを利用する際に重要な考え方だと感じました。
13. 認証・セキュリティ
認証は、ID/パスワードに加えてTOTP(Time-based One-Time Password(時間ベースのワンタイムパスワード))を使う設計です。
パスワードはArgon2idでハッシュ化しています。
PASSWORDS = PasswordHasher(
    time_cost=2,
    memory_cost=19456,
    parallelism=1,
    hash_len=32,
    salt_len=16,
    type=Type.ID,
)
秘密情報はAES-GCMを利用した暗号化部品を用意しています。
また、FastAPIの共通ミドルウェアでは、次のようなHTTPヘッダーを設定しています。
X-Content-Type-Options: nosniff
Referrer-Policy: no-referrer
Cache-Control: no-store
X-Frame-Options: DENY
Content-Security-Policy: ...
そのほか、CSRF対策、Trusted Host、セッション、権限制御、秘密情報を操作ログへ出さない仕組みなども実装しています。
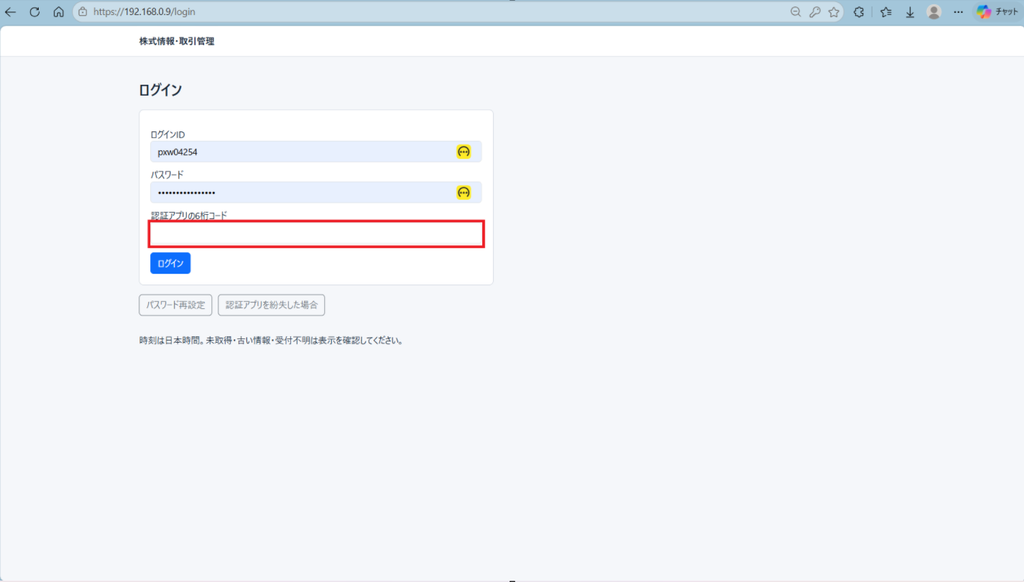
【画像12 :TOTP入力を含むログイン画面】
14. MySQLはマイグレーションで管理する
DB定義は db/migrations 配下にSQLとして管理しています。
001_auth.sql
002_market.sql
003_trading.sql
004_analysis_operations.sql
005_bridge_transport.sql
006_master_imports.sql
007_market_collection.sql
008_market_calendar.sql
009_notification_attempts.sql
010_auto_attempt_owner.sql
認証、株価、注文、分析、通知などの領域を分けて段階的に追加しています。
アプリケーション用DBユーザーについても、WEB、worker、migration、backupを分離する設計です。常駐処理からrootを利用しないようにしています。
15. テストもCodexに作らせる
今回、Codexには実装だけでなくテストコードも同時に作成させました。
テストは次のように分かれています。
tests/
├─ contracts/
├─ db/
├─ integration/
├─ security/
├─ ui/
└─ unit/
特に重要なのは、開発中の自動テストでは実証券APIや本番口座へ接続しないことです。
テスト用MySQL、偽API、偽SMTPなどを使い、外部通信を制限して確認しています。
実装途中の記録では248件の全体自動テスト合格、さらにWindowsの専用構築環境ではPython 3.13.16、独立MySQL、隔離Nginx、偽API/SMTPを利用した回帰試験で 378件合格 という記録まで確認できました。
ただし、これは「本番の全機能が受入済み」という意味ではありません。実ブラウザー、実口座、実注文、3名同時利用、完全な復元などは別の受入工程として管理しています。
テスト実行例は次のとおりです。
.\.venv\Scripts\python.exe -m pytest --mysql-test --nginx-test -q16. Windowsへのローカル構築
ローカル環境では、プログラム、runtime、鍵、DBデータ、ツールを分離する設計にしました。
KABUINFO_LOCAL/
├─ releases/
├─ runtime/
│  ├─ config/
│  ├─ logs/
│  ├─ state/
│  └─ work/
├─ keys/
├─ mysql-data/
└─ tools/
起動順は基本的に次のとおりです。
MySQL
  ↓
FastAPI / Uvicorn
  ↓
worker
  ↓
Nginx
  ↓
必要に応じて本人PCのbridge
プロジェクトにはPowerShellの補助スクリプトも用意しています。
scripts/start.ps1
scripts/stop.ps1
scripts/local_web.ps1
scripts/create_admin.ps1
scripts/prepare_release.ps1
scripts/restore.ps1
専用ローカル環境の起動例は次の形です。
.\scripts\local_web.ps1 -Action Start疎通確認は次のように行います。
.\scripts\local_web.ps1 -Action Check停止は次のとおりです。
.\scripts\local_web.ps1 -Action Stopなお、ブログへ掲載する際にはPC固有のIPアドレス、ユーザー名、証明書指紋、秘密情報、メールアドレスなどは掲載しないようにします。
17. Git/GitHubで管理する
VS Codeで修正した内容はGitで管理し、GitHubへPushしています。
今回のリポジトリでは、要件定義書、基本設計書、ソースコード、テスト、運用資料まで同じリポジトリ内で管理しています。
この方法には大きなメリットがありました。
コードだけではなく、「なぜこの仕様にしたのか」「どこまで試験したのか」「何が未完了なのか」まで同じ履歴で追えるためです。
AI駆動開発では、AIが短時間に大量のファイルを変更できるため、Gitの差分確認は特に重要です。
git status
git diff
git diff --check
git add .
git commit -m "Implement initial read-only release"
git push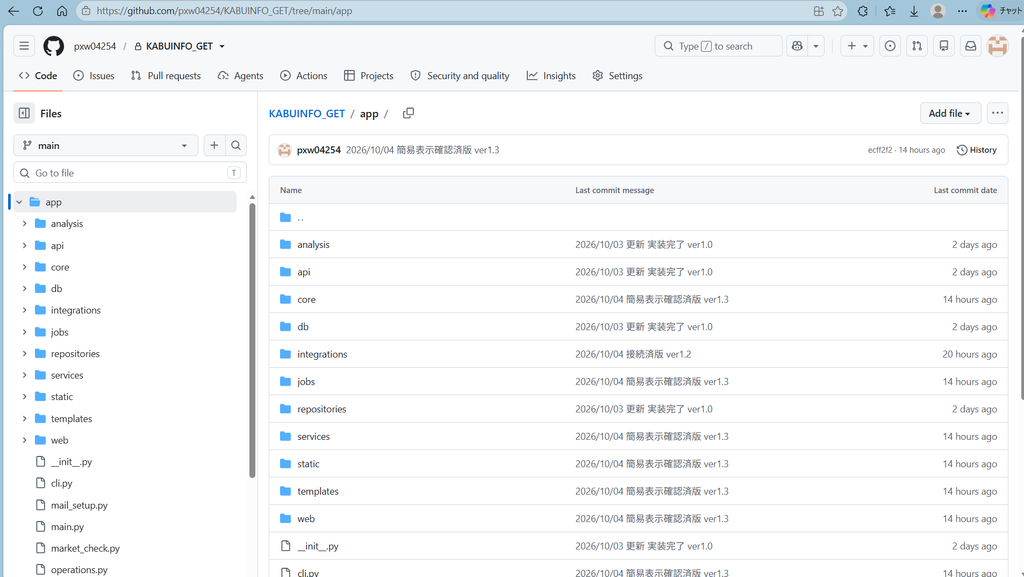
【画像13:GitHubのKABUINFO_GETリポジトリを開いた画面】
18. Codexを使って感じたこと
今回の開発で感じたのは、Codexは単なる「コード補完」ではなく、使い方次第で要件定義からテストまでかなり広い範囲を支援できるということです。
一方で、AIに任せる範囲を明確にしないと危険です。
特に今回のように外部API、認証、暗号化、注文処理、バックアップなどが関係するシステムでは、次の進め方が有効でした。
- 要望を文書として最初に固定する
- 不明点を推測させず確認事項へ回す
- 要件定義と設計をコードより先に作る
- 大きな機能をタスクへ分解する
- 1タスクごとに実装とテストをセットにする
- 実外部サービスへ勝手に接続させない
- 実装済みと受入済みを区別する
- Gitで必ず差分を確認する
- AIとは別の視点でコードレビューを行う
この最後の「AIとは別の視点でレビューする」ことも重要です。Codexで実装したコードを、別のChatGPTセッションへZIPで渡して全体レビューする方法も利用できます。まさかですが、何か障害に起因する処理が、埋め込まれていないことも確認できますので。
19. 今回の開発で特に良かった点
一番良かったのは、ソースコードだけでなく、要件・設計・タスク・試験結果・運用手順までCodexと一緒に残せたことです。
今回のリポジトリには、アプリ本体だけでなく、詳細設計、API契約、DB設計、実装対応表、受入計画、テスト結果、バックアップ/復元、Windows構築手順なども含まれています。
従来の開発であれば、設計書とプログラムが別々に更新されて内容がずれてしまうことがあります。AI駆動開発でも同じ問題は起きるため、設計変更時には関連文書とテストも一緒に更新させる方針が有効でした。
20. 今後の作業
現在は「コードが存在すること」と「実環境で安全に利用開始できること」を分けて管理しています。
今後は、初回の表示専用版について、ブラウザーでの実画面確認(デザインも変更)、認証、実APIの読取確認、バックアップ/復元などを順に確認します。
その後、注文・取消・分析・自動注文などを後続リリースとして開放する場合は、別リリースとして再度テストと受入を行う予定です。
金融取引に関係するシステムでは、AIがコードを作成できたからといって、そのまま本番利用へ進めるべきではありません。実装完了、自動テスト合格、実環境試験、利用者受入、利用開始判断を分けることが重要です。
まとめ
今回、VS CodeとCodexを使い、Python/FastAPI/MySQL/Nginxを中心とした株式情報取得WEBシステムを構築しました。
Codexを使うことで、大量のコードを短時間で作成できるだけでなく、要件定義、設計、タスク分割、テスト、運用資料まで一貫して作成できました。
一方で、うまく利用するためには「AIに全部任せる」のではなく、
ユーザー要望 → 確認事項 → 要件定義 → 基本設計 → タスク分割 → 実装 → 自動テスト → 実環境確認 → 受入
という工程を明確にしておくことが重要だと感じました。
今回のKABUINFO_GETでは、Codexを実装担当として利用しつつ、GitHubで変更履歴を管理し、テストと文書を残すことで、AI駆動開発でも追跡可能な形を目指しています。
今後は、実際の画面やCodexへの指示例、GitHubへの登録手順、実環境での確認内容についても、別記事として整理していく予定です。
共有する:
コメントを送信